本文不含未公开安全问题的目标、厂商、版本、接口、参数、凭据与复现细节。案例已抽象为问题类型,配图仅来自本机授权靶场。
0. 现场
第 4 个反编译窗口。
左边是伪 C,右边是抓包,底下压着三份笔记:组件、密钥,以及“这条到底验没验过”。
可疑点从来不缺。加固壳、没 strip 的 native 库、几十个导出组件、几条看起来能串起来的链路。真正耗时间的是另一件事:把“可疑”变成“可复核”。
要回答的只有四件事:结论来自哪个文件、哪一行;请求是谁发的、能不能重放;这是静态推断还是真机复现;三个月后还能不能看懂。
后来我们做了两个工具,Verdex 和 Fairy。它们不是更强的扫描器,只是把反复出现的动作固定下来,交给模型调用。
1. 类型
把这几年的目标摊开,类型很集中。
| 目标类型 | 主战场 | 反复出现的问题 |
|---|---|---|
| AI 陪伴 / 社交类 App | 客户端 + 实时协议 | 内容安全只在客户端、计费本地记账、私密数据明文落盘、令牌进 URL |
| 校园 / 生活服务类 App | 加固 + native + 业务 API | 硬编码签名密钥、导出组件、H5 与原生两套密钥、明文 HTTP |
| 学习 / 内容类 App | 大体积壳 + H5 资源 | 假 dex、字符串池泄露拓扑、WebView 桥、局域网页面 DOM XSS |
| 体质 / 健康类 App | native 密钥 + 组件面 | Java 加固但 native 裸奔、按接口分发的密钥表、FileProvider 过宽 |
| 开源 Web 系统 | 源码 + 鉴权 | SSRF、直链越权、鉴权注解缺失、JWT 密钥硬编码 |
问题大多不在扫描规则里,而在实现假设里。
开发者假设客户端会做校验,服务端就没有校验。假设加固能保护秘密,就把密钥挪进 native,却没有 strip。假设组件只给自己用,就不校验调用方。假设 URL 是官方拼的,深链参数就不做主机白名单。假设用户不会改本地状态,计费、内容安全、青少年模式就全在端侧。
这些假设,静态扫描器看不见,动态扫描器证不了。只能人工把代码、流量、运行时和业务语义拼在一起。
这件事听起来不聪明,但真正做过的人都知道,它最费时间。
2. 手工
最早是纯手工流水线。jadx 看 Java,Ghidra 看 .so,Frida 脱壳,mitmproxy 抓包,Python 写小工具,最后把截图和请求贴进报告。
能出结果,但边界很清楚。
2.1 切换
一个 APK 从拿到样本到能下结论,中间要换五六种工具。每换一次,就要重新加载上下文:这个类属于哪个 dex,这个函数在哪个 so,这个请求对应哪个页面。
环境是另一层摩擦。某次 bin_decompile 报“未找到 IDA/Ghidra”,查下来是 Ghidra 装在非默认目录,而工具只认默认路径或环境变量。建一个目录联接,伪 C 立刻出来了。之前“静态分析到此为止”的结论也被推翻:那个完整性校验不只是校验,它是签名功能的门控。
不是技术难题。是工程摩擦。摩擦会吃掉判断力。
2.2 证据
截图在 A 文件夹,请求在 B 文件夹,报告在 C 文档。写报告时靠记忆把三者拼起来。过两周,就说不清哪条验过、哪条只是看起来像。
误报也出现过不止一次。
某个 JS 文件扫出 private-key (PEM),一度以为是私钥泄露。核实后是加密库自带的 PEM 正则和生成函数。某个分享参数被当成访问凭证,真机交叉验证后发现只是埋点统计,连不存在的用户 id 都能渲染出同样内容。某个 FileProvider 配置了 root-path="/",静态看很吓人,真机验证没有可签发 URI 的链路,最后主动降级。
没有证据链的高危,不如一个诚实的待验证。
2.3 重复
每个目标都要重写一遍:解包、找 manifest、抽字符串、定位 native 符号、生成报告。脚本越写越多,大多只服务一个样本。
手工能建立直觉。直觉不沉淀,就只是一次性的运气。
flowchart LR
  A[样本 / 目标] --> B[解包 / 反编译]
  B --> C[Manifest / 字符串 / 符号]
  C --> D[Native / 密钥 / 签名]
  D --> E[抓包 / 真机验证]
  E --> F[证据链]
  F --> G[报告 / 报送]
这张图后来分成两套工具。左边是 Verdex,右边是 Fairy。中间那条证据链,是两者共用的语言。
3. Verdex
Verdex 的核心是只读。不联网,不执行目标,静态分析不替使用者动手。少数辅助工具只生成文本脚手架,执行仍然由人在授权范围内完成。
它要求每一层结论都带证据。
3.1 四层
- 资产:域名、URL、IP、文件、组件,带文件和行号。
- 关系:函数、路由、导入、调用关系。
- 数据流候选:source → sink,标注为静态推断。
- 人工结论:复核之后,才升级为已验证。
分层很啰嗦。但它解决了一个问题:模型不会把猜测说成事实。
3.2 链
对一个 APK,典型路径是:
analyze_target
  → mobile_unpack        # 解包、manifest、原生库、DEX
  → dex_decompile        # jadx → Java
  → bin_decompile        # Ghidra/IDA → 伪 C
  → bin_symbols/strings  # 没 strip 的 .so 等于半份源码
  → secrets              # 硬编码密钥/签名盐
  → report               # 不可变快照
固件走 fw_scan → fw_extract → bin_decompile → secrets。Electron 和小程序解包后走 JS 分析。
Verdex 通过 MCP 暴露成工具,模型直接调用。它不替模型判断,只把可复核的材料摆到桌上。
它不是红点生成器。判断仍然归人。
3.3 边界
某次拿到一个加固样本。classes.dex 体积异常巨大,头部声明的类却极少,真正的业务代码藏在密文载荷里。Java 层静态分析基本到头。
但它没有白跑。壳没有盖住的地方,信息量最大。
Manifest:上千个组件、几十个导出组件、深链和权限面。
字符串池:几十万条字符串、几百个域名、几套 WebView 桥的契约。
H5 资源:assets/ 里明文的 JS/HTML,直接就是源码。
Native 层:一百多个 .so,几个自有库保留了符号和调试字符串。
最后能拿证据说话的,是 H5 里的两条:局域网传书页通过明文 HTTP 加载远程脚本,以及文件名未转义直接拼 HTML 造成的 DOM XSS。两者串联,同网段攻击者或上游劫持者可以影响传书页里的文件操作。
静态分析的价值,不是脱壳成功,而是知道壳外还有什么。
3.4 后端
Verdex 的教训大多来自后端。
Windows 上没有 file,bin_info 直接失败。系统自带 tar 不认某些参数,mobile_unpack 要换实现。Ghidra 路径不匹配,bin_decompile 报未找到后端。jadx、IDA、ilspycmd 各有各的环境变量。
后来 Fairy 做样本交接,加了 preflight:逐条告诉模型这条链在本机缺哪个后端。缺 file 就标红 bin_info,缺 jadx 就标红 APK 的 DEX 链。
工具可以暂时不全。不能假装全。
4. Fairy
Verdex 停在网络边界内。web 侧需要的是另一套东西:登录、浏览器、会话、越权、参数、业务逻辑。
Fairy 是一层受控的请求层。
4.1 规矩
没有授权护照,一个包都不发。fairy.scope.json 必须写明 include、授权依据、操作者、限速、允许的方法。禁止 *,禁止 *.com 这种顶级通配。过期直接拒绝启动。
每一次请求都过闸门。校验、限速、发送、审计。每一步都有 request_id,报告里的每条发现都能回查原始请求。
只证明存在,不扩大影响。不注入破坏性载荷,不爆破,不 dump 数据,不改状态。反射只放无特殊字符标记。SQLi 只做错误签名和布尔差分。证到即停。
“能发请求”不是能力,是权限。权限就需要边界。
4.2 能力
浏览器运行时直接走本机 Chrome/Edge 的 CDP,零依赖。渲染 SPA,抓 XHR,看 DOM,读控制台,截图。Document / XHR / Fetch / WebSocket 在浏览器网络层过 scope,越界请求直接阻断。
认证态:单次登录,不重试,不爆破。会话可加密保存。双账号差分做 BOLA/IDOR 证据。
参数级探测:SQLi 错误/布尔差分,SSTI 求值。只判存在,不取数据。
DOM 上下文:标记落在 <script>、事件属性、普通属性还是文本,配合 CSP 给判定。
作战账本:资产、事实、发现、意图、覆盖。意图有依赖,只能领取前置完成的下一步。
攻击链知识库:CORS+凭证、OAuth 重定向、XSS、Git 泄露、BOLA、SSRF、API 文档、SourceMap,以及二进制样本交接。
交付:自包含 HTML 报告、脱敏 HAR、披露文档。web_report 产出的 HAR 可以回喂 Verdex 做第二遍静态复核。
样本交接:web 上发现 APK/固件/ELF,登记进账本,给出 Verdex 链和后端预检,再由模型去调 analyze_target。
这些只是基础设施。和成熟项目比,还差得远。
真正难的不是能发,是知道什么时候不发。
4.3 闸门
参数级探测和写操作默认关闭。
{
  "limits": {
    "rps": 5,
    "max_requests": 2000,
    "allow_active_probes": false,
    "methods": ["GET", "HEAD", "OPTIONS"]
  }
}
要测 SQLi/SSTI,必须同时满足两个条件:scope 里显式打开 allow_active_probes;调用时带 confirm: true。
登录同理。scope 必须显式允许 POST,否则连登录表单都不提交。
授权不是形式。每一步都要能回答:依据是什么。
4.4 测试
多个无头浏览器并行跑测试会互相拖死。后来改成每个测试文件独立进程、串行执行,并给 Browser.close 加硬超时。
Node 20 没有内置 WebSocket。浏览器功能需要 Node 22+,核心功能仍然支持 Node 20。
工具输出不能全量倾倒。报告、账本、审计要分层,模型只看摘要,细节按 request_id 回查。
测试只用本机靶场,不碰真实目标。49 项测试覆盖授权、账本、登录、BOLA、浏览器、参数探测、报告、交接。
5. 两只手
flowchart TB
  A[Agent / 模型] -->|MCP| F[Fairy / Web]
  A -->|MCP| V[Verdex]
  F -->|scope + audit| T[授权目标]
  F -->|traffic.har| V
  F -->|artifact handoff| V
  V -->|"file:line / 伪 C / 符号"| A
分工很简单。Fairy 看外面,Verdex 看里面。
典型闭环:
- Fairy 爬取、渲染、登录、差分,发现样本下载链接或可疑接口。
- 样本走
fairy_handoff:登记、算 sha256、给出 Verdex 链、预检本机后端。 - 模型调
mcp__verdex__analyze_target,按链解包、反编译、扫密钥。 - 静态结果回到 Fairy 的报告和账本,形成“样本 → 密钥 → 接口 → 验证”的链路。
- 需要动态确认的,用 Fairy 的浏览器、双账号、参数探测去证。证到即停。
两个工具都不假装自己什么都会。
6. 三个判断
6.1 签名
某次客户端逆向,从 native 库里还原了请求签名和密钥,离线复算成功。看起来是硬编码密钥,高危。
平台审核的意见很直接:
仅证明可以离线复算签名,未证明越权访问、身份冒用或业务影响,属于条件性理论风险。
这个判定没有问题。不能证明影响,就不能按影响定级。
要把它变成有影响,只剩三条路:冒充他人、骚扰第三方、篡改金额。三条都越过法律红线。
所以停手。
报告被驳回时,我没有去制造影响,而是把报告原封不动发给了厂商。真实的工程不是打 CTF 拿分,是帮客户解决问题。
6.2 真机
另一个案例,静态看是深链参数没有白名单。真正让它变成严重问题的,是运行时的顺序。
- 深链打开内置 WebView。
- WebView 先把会话 Cookie 写到即将加载的 URL 的域上。
- 再加载这个 URL。
一个攻击者可控的 HTTPS 页面,就能在自己的域上读到登录态。真机、自己的设备、自己的账号,复现成功。没有 root,没有 MITM,没有接触设备。
真机复现不是炫技。它让“严重”这个词有重量。
同一轮里也澄清了两个误报:加密库自带的 PEM 正则不是私钥;分享参数不是授权票据。
真机验证不只用来证明,也用来证伪。
6.3 设计
某 AI 陪伴类 App 的评估里,最刺眼的不是某个接口越权。
内容安全过滤的最终判定被写死为放行,整条链路形同虚设。语音通话的计费只在客户端记账,没有服务端扣费调用。私密聊天明文落盘,备份规则为空,云备份会带走。青少年模式在端侧,可以本地绕过。
共同点是产品把信任放在了客户端。
这些问题很难按单个 CVE 报送。但一旦成立,影响的是产品承诺本身。
7. 误报
7.1 几种
JS 加密库的 PEM 正则被扫成私钥泄露。分享参数被误认为访问凭证。FileProvider 配置很吓人,真机验证无法签发 URI,主动降级。布尔差分被动态页面和缓存干扰,必须人工复核。
规矩只有一条:静态发现一律标候选。没有 request_id、文件行号或真机证据,不进已验证。
7.2 流程
报送前先查重。站内检索,公开 CVE 比对,确认原创性。
通用软件认定、影响证明、修复状态,是三道独立的关。被驳回不代表发现是假的,可能只是类型不匹配。不要为了收录去制造影响。
同一份报告不要重复投。先发厂商,很多时候比平台有效。
7.3 工程
后端缺失是常态。file、jadx、Ghidra、ilspycmd、unzip/tar 都可能在 Windows 上出问题。工具要能解释自己为什么跑不动。
并行浏览器会互相拖死。测试要串行,要有超时,要有清理。
模型上下文有限。输出要分层,摘要优先,细节按 ID 回查。
工具不是越多越好。能稳定复现的一条链,胜过十个花哨的按钮。
8. 规矩
- 手动跑通,再自动化。同一个动作做到第三次,再写成工具。否则只是把错误固化。
- 报告先于利用。先想清楚怎么让别人复核,再想怎么打得更深。
- 保留否定结果。“这里验过,不成立”和“这里有问题”一样有价值。
- 工具要会说“不知道”。静态推断、候选、已验证,必须分开。缺后端就报缺后端。
- 授权是前提,不是免责声明。只碰自己的靶场、自己的账号、明确授权的范围。不 dump,不横向,不 hack-back。
9. 位置
我们很清楚,和 REA 以及这个领域里更成熟的项目相比,Verdex 和 Fairy 的人气、生态、工程完整度都不在同一个量级。这是事实,不需要修饰。
开源不等于被使用。Star、Issue、维护,都是另一件事。
Fairy 这个名字来自《绝区零》里绳匠的那只 AI。目前它还不会记住一个目标的历史,不会自己判断这一步该不该停,也不会自己决定下一步打哪。
但它已经有两样东西。手,能在授权范围内发请求、开浏览器、登录、差分、证明。纪律,授权护照、逐请求审计、数据最小化、证到即停。
Verdex 是那只只读的手,Fairy 是那只敢碰网络的手。两只手都不完美。
但至少,它们不会在凌晨三点把同一份报告再写一遍。
现在是凌晨三点,第 4 个反编译窗口已经关了。希望下一次,系统能自动把这些窗口收拾好,让我能去安心睡个觉。
- Verdex: https://github.com/Yilanchia/Verdex
- Fairy / Web: https://github.com/Yilanchia/fairy_web
- 许可:MIT
只对授权目标动手。发现敏感数据即停,不 dump,不横向,不 hack-back。
注脚
Verdex 被 XERJ Corpus Hub 收录为参考语料(Contributor since 2026-10-19,条目 yilanchia–verdex)。算是给这套工具的一份外部注脚。
附录
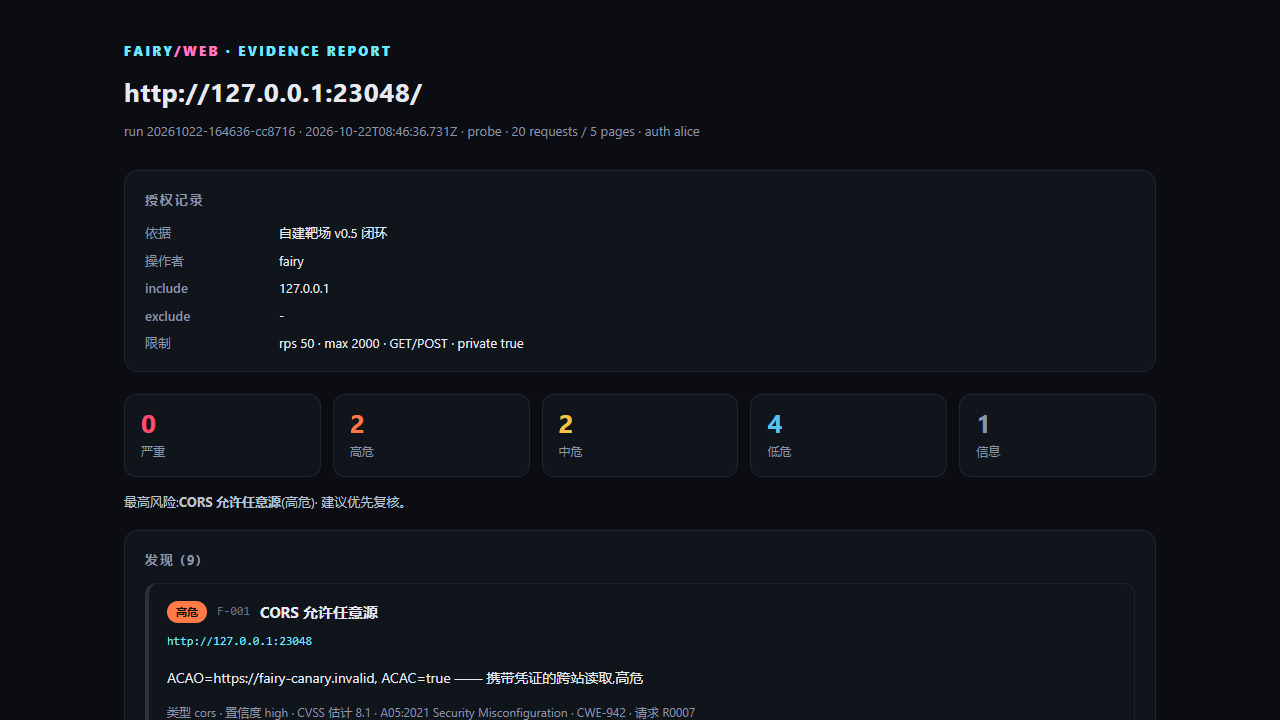
一次本机授权靶场的自包含报告。每条发现带 OWASP/CWE/CVSS 估计、修复建议、复现步骤和 request_id。
CDP 浏览器运行时渲染 SPA 后的截图。动态链接和 XHR 会被记录,越界请求在浏览器网络层被阻断。